מודלים ותשתית · קוד פתוח
What’s in the RedPajama-Data-1T LLM training set
מדובר במאגר נתונים בקוד פתוח המכיל 1.2 טריליון טוקנים, שנוצר משיתוף פעולה בין Together, אונטוקורד, ETH DS3Lab, סטנפורד CRFM, Hazy Research ומכון מילה בקוויבק. המטרה שלו היא לשחזר את מערך הנתונים ששימש לאימון מודל LLaMA המקורי של מטא.
ההבדל העיקרי הוא הנגישות המלאה של קובצי המקור. במקום להסתמך על תיאורים במאמרים אקדמיים, מקבלים גישה ישירה לנתונים הגולמיים שמרכיבים את המאגר כדי לאמן מודלים באופן עצמאי.
- מודלים ותשתית
- קוד פתוח
- ממשק באנגלית
דירוג הקהילה
תהיו הראשונים לדרג.
איך הדירוג עובד+
הדירוג פתוח רק למי שמחובר עם חשבון גוגל, דירוג אחד לכל אדם לכל כלי. זו הדרך שלנו לוודא שמדובר באדם אמיתי: היא אינה מוכיחה שהמדרג השתמש בכלי, וזה הבדל שכדאי לזכור כשקוראים ממוצע.
מי שכותב ביקורת מוצג בשמו הפרטי בלבד, כפי שהוא מופיע בחשבון גוגל. מעבר לזה לא נשמר דבר: לא שם משפחה, לא כתובת דוא״ל ולא תמונה: רק גיבוב חד־כיווני של מזהה החשבון, שמאפשר לכם לשנות את הדירוג שלכם ולא מאפשר לנו לדעת מי אתם.
ביקורת אינה יכולה להכיל קישורים, כתובות דוא״ל, מספרי טלפון או שמות משתמש. זה לא סינון תוכן, זה מה שמונע ממקום כזה להפוך ללוח מודעות.
- תמחור
- קוד פתוח
- קטגוריה
- מודלים ותשתית
- שפת האתר
- אנגלית
- כתובת
- simonwillison.
net - נבדק
- 2026-09-09
הסקירה
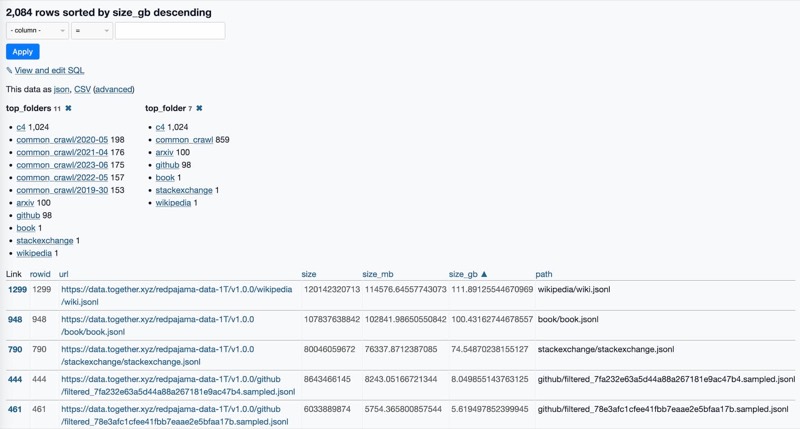
כשמורידים את קובץ הקישורים של RedPajama-Data-1T, מקבלים רשימה יבשה של 2,084 כתובות רשת שמובילות לנפח עצום של 2.67TB. זה לא כלי תוכנה שמתקינים בלחיצת כפתור כדי לסכם מסמכים במשרד, אלא מאגר נתונים גולמי לאימון מודלי שפה שמנסה לשחזר במדויק את המקור של מודל LLaMA. המאגר כולל 1.2 טריליון טוקנים שחולקו לקבצים בפורמט JSONL, שזה למעשה שורות נפרדות של אובייקטי JSON המכילים טקסט ומטא-דאטה בסיסי. הפרויקט הזה נבנה בשיתוף פעולה בין Together לבין גופים אקדמיים כמו Stanford CRFM, במטרה להעמיד נתוני אימון פתוחים לקהל הרחב בלי תלות בחברות ענק.
ההבדל העיקרי בינו לבין מה שהיה נהוג עד שפורסם הוא השקיפות המלאה של הקבצים והמקורות. במקום לטעון מודל קופסה שחורה שאיש אינו יודע מה הוזן לתוכו, כאן אפשר לפתוח כל קישור ולבדוק מה בדיוק נכנס לתערובת. התוכן מתבסס בעיקר על דפי רשת סרוקים, קטעי קוד ומאמרים מדעיים, כאשר המטרה המוצהרת היא לאפשר לכל חוקר לשחזר את תהליך הלמידה של מודלי שפה מובילים מאפס. מדובר בפתרון פתוח, אבל הצריכה שלו דורשת הבנה טכנית עמוקה ויכולת להתמודד עם מסדי נתונים מסיביים.
מה באמת מסתתר בפנים
עיקר המשקל של המאגר נשען על נתוני רשת גולמיים ומעובדים. הנתח הגדול ביותר מגיע ממאגר C4 שתופס 806GB המחולקים על פני 1,024 קבצים נפרדים, כשלצידו מופיעים חמישה סבבים שונים של Common Crawl בנפחים שנפרסים בין 237GB ל-288GB לכל סבב. הנתונים האלה עברו סינון איכות ייעודי שנועד לשמור על דפים שנראים כמו ערכים אנציקלופדיים, בנוסף לקבצי קוד מתוך GitHub שמסתכמים ב-212GB, ומאמרים מדעיים מתוך arxiv בנפח של 87GB. אפילו שיחות טכניות שלמות מתוך stackexchange נכללו פנימה בקובץ יחיד של 74GB.
חלק מעניין במיוחד נמצא בקובץ הטקסטים של הספרים שנקרא book.jsonl ותופס 100GB שלמים. בדיקה של מאה המגה-בייט הראשונים מראה שהטקסטים נלקחו מפרויקט Gutenberg, ובראשם מהדורת תנ"ך מפורסמת משנת 1611. הקובץ מכיל שדות ברורים של כותרת הספר, שנת ההוצאה לאור והכתובת המקורית ברשת לצד הטקסט המלא עצמו. הנתונים מוגשים בצורה נקייה מאוד, אך עדיין דורשים כוח מחשוב רציני כדי לעבד אותם ברצף.
ההורדה דורשת רוחב פס עצום.
רכיבי המאגר העיקריים
- 01טקסטים מסוננים ממאגר C4
- 02סריקות רשת מרובות ממאגר Common Crawl
- 03מאגר קוד מקור מתוך GitHub
- 04מאמרים אקדמיים ממאגר arxiv
- 05ספרים מלאים מפרויקט Gutenberg
עלויות ומשאבים שצריך להכיר
מבחינת תמחור ישיר, הנתונים עצמם מוגדרים open-source וזמינים להורדה חופשית דרך שרת ייעודי, אבל המילה חינם מטעה מאוד כאן. ברגע שאתם מנסים למשוך 2.67TB לקונסולת ענן או לשרת מקומי, עלויות התעבורה והאחסון נכנסות לפעולה מיד ויכולות להגיע למאות דולרים בחשבון החודשי שלכם. סביר להניח שתצטרכו לשלם על נפחי אחסון מהירים במיוחד כמו כונני NVMe ייעודיים, אחרת תהליך האימון או השליפה שלכם פשוט יזחל. בנוסף, מי שאינו רוצה להוריד את הכל בבת אחת נאלץ לבנות סקריפטים כדי לסנן את הקישורים מראש.
ההוצאה האמיתית היא על המחשוב.
אם אתם מחפשים תמיכה בעברית, המאגר הזה כמעט לא רלוונטי עבורכם. הנתונים משקפים בעיקר את האינטרנט דובר האנגלית, כפי שתואר במאמר המקורי של LLaMA, והמקורות המרכזיים כמו Gutenberg, ספריות הקוד ופורומי התכנות מכוונים כולם לשפה האנגלית. לא הייתי משתמש בזה כדי לאמן כלי שאמור לפעול מול לקוחות מקומיים בישראל, כי חומרי המקור פשוט לא שם. תצטרכו להשקיע מאמץ כפול ולצרף נתונים מקומיים ממקורות חיצוניים כדי להשיג רמת שפה סבירה.
מה שבאמת מפריע כאן הוא שאין שום מנגנון רשמי לסינון כפילויות בין חמשת סבבי הסריקה השונים שנאספו מ-2019 ועד 2022. התוצאה היא שדפי רשת פופולריים כנראה מופיעים שם כמה וכמה פעמים, מה שעלול להטות את המשקולות של מודל שנשען עליהם. זה שווה את זה רק אם אתם מאמנים מודל בסיס עצמאי ומחפשים נתוני עתק מוכנים מראש. לכל משימה עסקית שגרתית, המאגר הזה הוא סירבול מיותר לחלוטין שלא יניב ערך.
- רישיון מאגרקוד פתוח מלא
- נפח הורדה2.67TB נתונים גולמיים
- תמיכה בעבריתלא מתאים לשפה
מה What’s in the RedPajama-Data-1T LLM training set
עושה
הנתונים מחולקים ל־2,084 קבצים בפורמט JSONL, שבהם כל שורה מכילה לרוב שדה טקסט לצד מטא-דאטה. הנפח הכולל של ההורדה מגיע ל־2.67 טרה-בייט, ואפשר למשוך את כל הקבצים ישירות באמצעות רשימת כתובות ופקודת wget פשוטה.
המאגר מורכב ממספר מקורות מרכזיים, כאשר חלק ניכר ממנו מגיע מחמישה מחזורי סריקה שונים של Common Crawl וממאגר C4 הנקי שתופס כ־806 גיגה-בייט. שאר החומרים כוללים 212 גיגה-בייט מקוד ב־GitHub, מאגר ויקיפדיה של 111 גיגה-בייט, 100 גיגה-בייט של ספרים מפרויקט גוטנברג, מאמרי ArXiv ודיונים מ־StackExchange.
כמה זה
עולה
האתר לא מפרסם מחיר עבור המאגר עצמו, והגישה לקבצים פתוחה להורדה.
המספרים נקראו מעמוד התמחור של What’s in the RedPajama-Data-1T LLM training set ב־2026-09-09. תמחור משתנה. לפני החלטה כדאי לפתוח את עמוד התמחור עצמו.
למי זה
מתאים
זה מיועד לחוקרי בינה מלאכותית, מהנדסי למידת מכונה וצוותי פיתוח שרוצים לאמן מודלי שפה מאפס על בסיס נתונים פתוח ורחב. צריך תשתיות אחסון כבדות ויכולת עיבוד כדי להתמודד עם נפח כזה.
מי שמחפש פתרון מוכן לשימוש, כלי עזר משרדי, או פשוט רוצה לשוחח עם בוט מוכן, יבזבז פה זמן. אין כאן ממשק משתמש או מודל מאומן שמחזיר תשובות.
מה לבדוק
לפני שמתחייבים
לפני שמתחילים להוריד, תבדקו שיש לכם לפחות 2.67 טרה-בייט פנויים בכונן וחיבור רשת יציב מאוד. בנוסף, קחו בחשבון שחלקים נרחבים נשענים על סריקות רשת ישנות באנגלית מפרויקטים כמו Common Crawl וספרים עתיקים מגוטנברג, כך שאין כאן התאמה מיוחדת לעברית וייתכנו כפילויות בין סריקות הרשת השונות.
מה אומרים
המשתמשים
עוד אף אחד לא כתב על What’s in the RedPajama-Data-1T LLM training set כאן. אם השתמשתם בWhat’s in the RedPajama-Data-1T LLM training set, השורה הראשונה היא שלכם.
מה What’s in the RedPajama-Data-1T LLM training set
אומר על עצמו
RedPajama is “a project to create leading open-source models, starts by reproducing LLaMA training dataset of over 1.2 trillion tokens”. It’s a collaboration between Together, Ontocord.ai, ETH DS3Lab, Stanford CRFM, …
מהאתר של What’s in the RedPajama-Data-1T LLM training set, נקרא ב־2026-09-09. הטקסט הוא שלהם.
אנחנו לא מתרגמים תיאורי שיווק ומגישים אותם ככתיבה שלנו. שיטת העבודה.
שאלות
נפוצות
איך בנויים קובצי המידע בפנים?
החומר שמור בפורמט JSONL, שבו כל שורה מייצגת רשומה נפרדת. במבנה הטיפוסי יש מפתח טקסט עם התוכן עצמו, לצד מילון נתונים עם כותרת, תאריך פרסום או כתובת המקור.
האם אפשר להשתמש בזה בלי להוריד את כל הנפח?
אפשר לגשת לכתובות הקבצים הבודדים ולהוריד רק מקורות ספציפיים לפי הצורך. יש אפשרות גם לבחון מראש את הגדלים והמבנה של הקבצים באמצעות שאילתות וכלים כמו Datasette Lite.
מה What’s in the RedPajama-Data-1T LLM training set עושה?
מדובר במאגר נתונים בקוד פתוח המכיל 1.2 טריליון טוקנים, שנוצר משיתוף פעולה בין Together, אונטוקורד, ETH DS3Lab, סטנפורד CRFM, Hazy Research ומכון מילה בקוויבק. המטרה שלו היא לשחזר את מערך הנתונים ששימש לאימון מודל LLaMA המקורי של מטא. ההבדל העיקרי הוא הנגישות המלאה של קובצי המקור. במקום להסתמך על תיאורים במאמרים אקדמיים, מקבלים גישה ישירה לנתונים הגולמיים שמרכיבים את המאגר כדי לאמן מודלים באופן עצמאי.
האם What’s in the RedPajama-Data-1T LLM training set חינמי?
לפי מה שהאתר של What’s in the RedPajama-Data-1T LLM training set מפרסם, קוד פתוח. תנאים משתנים. כדאי לאמת מול עמוד התמחור שלו.
האם What’s in the RedPajama-Data-1T LLM training set תומך בעברית?
האתר של What’s in the RedPajama-Data-1T LLM training set מוגש באנגלית. זה לא אומר שהכלי לא יעבוד עם טקסט בעברית, אבל זה כן אומר שהוא לא נבנה סביבה.
יש חלופות ל־What’s in the RedPajama-Data-1T LLM training set?
כן. באתר יש 101 כלים בקטגוריית מודלים ותשתית, וחלקם מוצגים בתחתית העמוד הזה. ההשוואה שכדאי לעשות היא בין תמחור, שפת הממשק והתאמה למה שאתם צריכים לעשות, לא בין רשימות תכונות.
כלים דומיםבמודלים ותשתית
כל 101 הכלים-
 בתשלום
xAI
גישה למודל Grok 4.6 לפיתוח תוכנה, קול, תמונה וטקסט דרך ממשק תכנות אחיד.
-
 קוד פתוח
Z.AI Developer Platform
גישה דרך ממשק תכנות למודלי שפה, קוד, תמונה ווידאו ממשפחת GLM
-
 לא צוין
A simple guide to fine-tuning Llama 2 | Brev docs
גישה והרצה של כרטיסי מסך וסביבות עבודה לבינה מלאכותית מטרמינל יחיד.
-
 בתשלום
adaptive-rag
התאמת כמות מסמכי ההקשר לפניות למודלי שפה כדי לחסוך בעלויות שימוש.
-
 לא צוין
AIWatch
מעקב זמינות בזמן אמת אחרי 45 שירותי AI, כולל ChatGPT ו־Claude.
-
 קוד פתוח
Arize AI
ניטור, מעקב והערכת ביצועים לסוכני בינה מלאכותית וקריאות מודלי שפה.