מודלים ותשתית · בתשלום

adaptive-rag
מדובר בתבנית פיתוח מתוך ספריית הקוד של חברת פאת'ווי, שמיועדת למפתחים הבונים מערכות מענה על שאלות מתוך מסמכים. במקום לשלוח בכל פעם כמות קבועה וגדולה של טקסט לתוך חלון ההקשר, התבנית משנה את מספר המסמכים שנשלחים לפי הצורך של השאלה הספציפית.
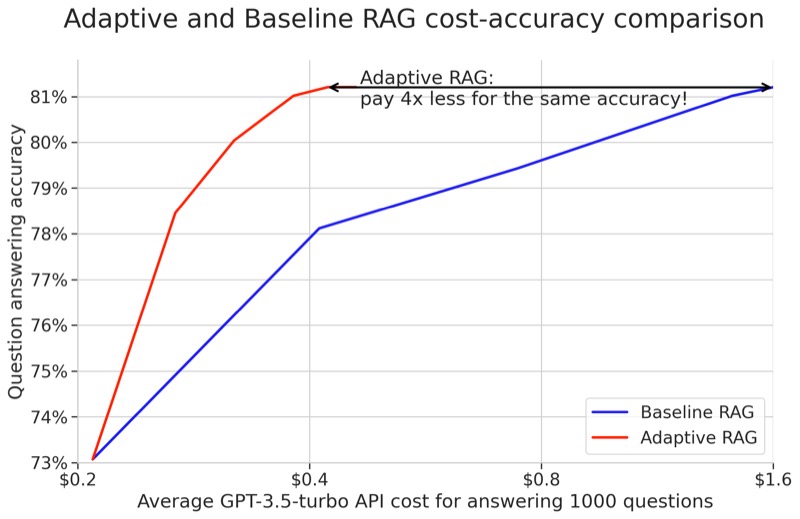
ההבדל המרכזי מול ארכיטקטורות שליפה רגילות הוא השימוש במשוב חוזר מהמודל. אם המודל לא מוצא תשובה בהקשר מצומצם, מגדילים את כמות המסמכים. הגישה הזו חותכת את נפח הטוקנים ומגיעה לפי נתוני החברה לחיסכון של פי ארבעה בעלויות הקריאה למודל בלי לפגוע בדיוק.
- מודלים ותשתית
- בתשלום
- ממשק באנגלית
דירוג הקהילה
תהיו הראשונים לדרג.
איך הדירוג עובד+
הדירוג פתוח רק למי שמחובר עם חשבון גוגל, דירוג אחד לכל אדם לכל כלי. זו הדרך שלנו לוודא שמדובר באדם אמיתי: היא אינה מוכיחה שהמדרג השתמש בכלי, וזה הבדל שכדאי לזכור כשקוראים ממוצע.
מי שכותב ביקורת מוצג בשמו הפרטי בלבד, כפי שהוא מופיע בחשבון גוגל. מעבר לזה לא נשמר דבר: לא שם משפחה, לא כתובת דוא״ל ולא תמונה: רק גיבוב חד־כיווני של מזהה החשבון, שמאפשר לכם לשנות את הדירוג שלכם ולא מאפשר לנו לדעת מי אתם.
ביקורת אינה יכולה להכיל קישורים, כתובות דוא״ל, מספרי טלפון או שמות משתמש. זה לא סינון תוכן, זה מה שמונע ממקום כזה להפוך ללוח מודעות.
- תמחור
- בתשלום
- קטגוריה
- מודלים ותשתית
- שפת האתר
- אנגלית
- כתובת
- pathway.
com - נבדק
- 2026-09-09
הסקירה
כששולחים שאילתה לתוך מנגנון חיפוש מבוסס מסמכים, ברירת המחדל הרגילה דוחפת מספר קבוע של פסקאות אל תוך הפרומפט של מודל השפה. הטמפלט של adaptive-rag מבית Pathway משנה את הנקודה הזו. במקום לזרוק תמיד חמישים או מאה מסמכים פנימה, הקוד בודק את התשובה שהתקבלה ומגדיל את ההקשר רק כשמודל השפה מודיע שהוא לא מצא מענה. הוא מתחיל ממספר קטן של פסקאות מקור, קורא את התגובה, ומרחיב את החיפוש בהדרגה לפי הצורך.
הניסויים שלהם מראים שמסמך בודד מספק תשובה נכונה בשישים ושמונה אחוזים מהמקרים, בעוד שעשרה מסמכים מעלים את הדיוק לקרוב לשמונים אחוזים. מעבר לזה מתחילה שחיקה בתועלת. חמישים מסמכים מביאים את הדיוק למעט מעל שמונים ושניים אחוזים, אבל במאה מסמכים הביצועים כבר יורדים. מודלים כמו gpt-3.5-turbo פשוט מתבלבלים כשהטקסט ארוך מדי ומייצרים הזיות במקום לענות נכון. המנגנון כאן מנסה לעצור לפני שמגיעים לאזור המבלבל הזה.
איך המנגנון עובד בקוד
בניסוי שלהם על מאגר SQUAD של Stanford, הם חילקו חמישים מאמרי ויקיפדיה לפסקאות ואינדקסו כאלפיים וחמש מאות רשומות בעזרת OpenAI ADA-002. כל שאילתה מומרת לווקטור ונמדדת לפי מרחק קוסינוס. ההוראה למודל ברורה ומבוססת על QueryCitationEngine של LlamaIndex: אם אין מידע במקורות, הוא חייב לכתוב שלא מצא תשובה, וכשיש מידע, הוא חייב לצטט את מספר המקור בסוגריים מרובעים. הגישה הזו חותכת את עלויות השימוש במודל פי ארבעה בלי לפגוע ברמת הדיוק של התשובות. הציטוטים מאפשרים לבדוק מאיפה הגיעה כל עובדה.
לא הייתי משתמש בזה אם אתם מחפשים כלי מדף עם כפתור הפעלה גרפי.
זה לא מוצר סופי אלא תבנית פיתוח שיושבת בתוך Pathway Live Data Framework ודורשת כתיבת קוד בפייתון. אתם תצטרכו להגדיר את החיבורים למקורות המידע, לנהל את המפתחות של OpenAI, ולדאוג להרצה של הצינור בעצמכם. אם אתם מתכנתים שבונים פתרון לשאלות ותשובות על חוזים משפטיים או שקפים בארגון, הקוד הזה יחסוך לכם שעות של ניסויים על התאמת גודל חלון ההקשר. למי שמחפש פתרון ללא קוד, התבנית הזו לא תעזור בכלל.
שלבי העבודה של המודל
- 01וקטוריזציה עם OpenAI ADA-002
- 02שליפת פסקאות לפי דמיון קוסינוס
- 03בניית פרומפט עם ציטוטי מקור
- 04זיהוי תשובה חסרה מהמודל
- 05הרחבת כמות המסמכים בסבב נוסף
כמה זה עולה בפועל
הגישה לטמפלט עצמו פתוחה למפתחים באתר, אבל הרישום מסווג כשירות בתשלום. החומר הרשמי לא מציין מחיר נקוב בדולרים, מסלולים חודשיים או מדרגות שימוש. כדי לדעת כמה תשלמו על שימוש בטכנולוגיה של החברה תצטרכו לפנות ישירות לצוות המכירות שלהם. מעבר לעלות הפלטפורמה, אתם נושאים ישירות בעלויות ה־API מול OpenAI על יצירת וקטורים והרצת השאילתות במודל.
החיסכון בטוקנים אמיתי ומורגש.
ההבדל המשמעותי בתקציב נובע מהעובדה שמרבית השאלות הפשוטות נסגרות מול מודל השפה בפרומפט קצר מאוד. במקום לשלם על עשרות אלפי טוקנים בכל שאילתה כדי לכסות מקרי קצה נדירים, המערכת משלמת מחיר מינימלי על רוב השאלות ומשקיעה טוקנים רק כשמתעורר צורך אמיתי. הניתוח שלהם מראה שצירוף יותר מדי מסמכים לא רק עולה כסף אלא מגדיל ישירות את כמות ההזיות, מה שהופך את הקיצוץ בטוקנים ליתרון מקצועי ולא רק כלכלי.
מה שבאמת מפריע כאן הוא שאין שום אזכור להתמודדות עם עברית. כל הבדיקות והטקסטים מבוססים על אנגלית ועל ספריות כמו nltk לניקוי מילות יחס וחיתוך הטיות. בעברית מודלים וקטוריים מתנהגים אחרת, ועיבוד הטקסט המקדים ידרוש מכם התאמות ידניות מורכבות.
- תמחור רשמיבתשלום ללא מחיר נקוב
- קוד פתוחדוגמאות קוד זמינות באתר
- תמיכה בעבריתלא מתועדת בחומר
מה adaptive-rag
עושה
התהליך מתחיל בהפיכת מאגר המידע לפסקאות ווקטוריות באמצעות מודל שיבוץ, כמו אופנאיי ADA-002, וחיפוש קוסינוס לפי שאלת המשתמש. התבנית יוצרת פרומפט ראשוני שמכיל מספר קטן מאוד של מסמכים רלוונטיים ומבקשת מהמודל לענות בצירוף ציטוט המקור, או להחזיר תשובה שלילית אם המידע אינו קיים.
אם המודל מדווח שלא מצא תשובה במסמכים שצורפו, המערכת מרחיבה את ההקשר ומספקת יותר פסקאות. בניסויים שהציגו על בסיס נתוני ויקיפדיה ומודל ג'יפיטי 3.5 טורבו, שילוב של מסמך אחד נתן דיוק של 68 אחוזים, עשרה מסמכים הגיעו לכמעט 80 אחוזים, והעמסה של מעל חמישים או מאה מסמכים כבר יצרה בלבול והזיות.
כמה זה
עולה
האתר אינו מפרסם מחיר עבור השימוש בתבנית או בכלים הנלווים.
למי זה
מתאים
התבנית מתאימה לצוותי פיתוח ומהנדסי נתונים שכבר מריצים מערכות שליפה ומענה בארגון ורואים את חשבונות ה־API תופחים. היא נותנת מענה ישיר למי שמנתח מאגרי חוזים, תיעוד טכני או שאלות משתמשים ורוצה לצמצם את כמות הטוקנים המבוזבזים.
היא לא מתאימה למי שמחפש מוצר מדף מוכן בלחיצת כפתור, למי שאין לו מתכנתים בצוות, או לפרויקטים קטנים שבהם נפח השאילתות כה נמוך שעלויות ה־API אינן מהוות שיקול כלכלי.
מה לבדוק
לפני שמתחייבים
לפני שממהרים לשלב את הקוד, צריך לזכור שהוא מבוסס על ספריות הפיתוח של פאת'ווי, מה שמחייב היכרות ועבודה עם סביבת הריצה שלהם. אם הקוד שלכם כבר כתוב בספריות אחרות, תצטרכו להחליט אם שווה לעשות התאמות או לשכתב את הלוגיקה אצלכם.
בנוסף, המדידות והפרומפטים שמוצגים באתר נוסחו באנגלית ונבדקו על מודלי שיבוץ מערביים. צריך לבדוק בפועל איך התבנית הזו מתמודדת עם שאלות בעברית ואיך ההנחיות לציטוט מקורות עובדות כשמערבבים מודלים וטקסטים מקומיים.
מה אומרים
המשתמשים
עוד אף אחד לא כתב על adaptive-rag כאן. אם השתמשתם בadaptive-rag, השורה הראשונה היא שלכם.
מה adaptive-rag
אומר על עצמו
This article presents Adaptive RAG: a new technique to decrease the cost of RAGs without sacrificing accuracy
מהאתר של adaptive-rag, נקרא ב־2026-09-09. הטקסט הוא שלהם.
אנחנו לא מתרגמים תיאורי שיווק ומגישים אותם ככתיבה שלנו. שיטת העבודה.
שאלות
נפוצות
איך המודל נמנע מלהמציא עובדות כשיש מעט מדי מידע?
הפרומפט מנחה את המודל לכתוב במפורש שלא מצא תשובה אם המידע חסר, ומחייב אותו לצטט את מספר המקור בכל קביעה. מהניתוח שערכו עולה שככל שמספקים פחות מסמכים המודל נוטה יותר להודות שאינו יודע, בעוד שעודף מסמכים מגביר את שיעור ההזיות.
איך נבדק הדיוק של התשובות בניסויים שלהם?
הם השתמשו במאגר שאלות של סטנפורד, ניקו מילות יחס בעזרת ספריית NLTK, ביצעו חיתוך לשוני של המילים ובדקו האם המילים הרלוונטיות מתשובת המקור מופיעות בתשובה שניפק המודל.
מה adaptive-rag עושה?
מדובר בתבנית פיתוח מתוך ספריית הקוד של חברת פאת'ווי, שמיועדת למפתחים הבונים מערכות מענה על שאלות מתוך מסמכים. במקום לשלוח בכל פעם כמות קבועה וגדולה של טקסט לתוך חלון ההקשר, התבנית משנה את מספר המסמכים שנשלחים לפי הצורך של השאלה הספציפית. ההבדל המרכזי מול ארכיטקטורות שליפה רגילות הוא השימוש במשוב חוזר מהמודל. אם המודל לא מוצא תשובה בהקשר מצומצם, מגדילים את כמות המסמכים. הגישה הזו חותכת את נפח הטוקנים ומגיעה לפי נתוני החברה לחיסכון של פי ארבעה בעלויות הקריאה למודל בלי לפגוע בדיוק.
האם adaptive-rag חינמי?
לפי האתר שלו: בתשלום. מומלץ לאמת מול עמוד התמחור, כי תנאים משתנים.
האם adaptive-rag תומך בעברית?
האתר של adaptive-rag מוגש באנגלית. זה לא אומר שהכלי לא יעבוד עם טקסט בעברית, אבל זה כן אומר שהוא לא נבנה סביבה.
יש חלופות ל־adaptive-rag?
כן. באתר יש 101 כלים בקטגוריית מודלים ותשתית, וחלקם מוצגים בתחתית העמוד הזה. ההשוואה שכדאי לעשות היא בין תמחור, שפת הממשק והתאמה למה שאתם צריכים לעשות, לא בין רשימות תכונות.
כלים דומיםבמודלים ותשתית
כל 101 הכלים-
 לא צוין
AIWatch
מעקב זמינות בזמן אמת אחרי 45 שירותי AI, כולל ChatGPT ו־Claude.
-
 קוד פתוח
Arize AI
ניטור, מעקב והערכת ביצועים לסוכני בינה מלאכותית וקריאות מודלי שפה.
-
B בתשלום
Baseten
התחברות וניהול גישה לחשבון באמצעות דוא״ל, גוגל או גיטהאב.
-
 תקופת ניסיון
BigML
פלטפורמת למידת מכונה שמיועדת גם למי שאינו מדען נתונים.
-
 לא צוין
BigModel
הפלטפורמה הפתוחה של Zhipu למודלים סיניים, כולל רב־מודליים.
-
 קוד פתוח
BLOOM
מודל שפה רב לשוני בקוד פתוח עם 176 מיליארד פרמטרים שזמין להרצה חופשית