מחקר וחיפוש · קוד פתוח

SEAL LLM Leaderboard
SEAL של Scale AI בונה מבחנים סגורים שמומחים כתבו, כדי שהמודלים לא יוכלו להתאמן עליהם. זה מנטרל בעיה אמיתית בדירוגים ציבוריים, שבהם מבחן שהתפרסם מאבד ממשמעותו.
- מחקר וחיפוש
- קוד פתוח
- ממשק באנגלית
דירוג הקהילה
תהיו הראשונים לדרג.
איך הדירוג עובד+
הדירוג פתוח רק למי שמחובר עם חשבון גוגל, דירוג אחד לכל אדם לכל כלי. זו הדרך שלנו לוודא שמדובר באדם אמיתי: היא אינה מוכיחה שהמדרג השתמש בכלי, וזה הבדל שכדאי לזכור כשקוראים ממוצע.
מי שכותב ביקורת מוצג בשמו הפרטי בלבד, כפי שהוא מופיע בחשבון גוגל. מעבר לזה לא נשמר דבר: לא שם משפחה, לא כתובת דוא״ל ולא תמונה: רק גיבוב חד־כיווני של מזהה החשבון, שמאפשר לכם לשנות את הדירוג שלכם ולא מאפשר לנו לדעת מי אתם.
ביקורת אינה יכולה להכיל קישורים, כתובות דוא״ל, מספרי טלפון או שמות משתמש. זה לא סינון תוכן, זה מה שמונע ממקום כזה להפוך ללוח מודעות.
- תמחור
- קוד פתוח
- קטגוריה
- מחקר וחיפוש
- שפת האתר
- אנגלית
- כתובת
- labs.
scale. com - נבדק
- 2026-09-08
הסקירה
אתם נכנסים לכתובת labs.scale.com ומקבלים מול העיניים טבלאות דירוג שמשוות ביצועים של מעל 100 דגמי בינה מלאכותית מול יותר מ־20 מבחני ביצועים שונים. האתר לא מציע תיבת צ'אט או כפתור להרצת פרומפטים משלכם. הוא מציג תוצאות שנמדדו במעבדה על מודלים של חברות כמו OpenAI, Anthropic, Google ו־Meta, לצד תורמי קוד פתוח. המטרה כאן היא לתעד איפה המודלים מצליחים ואיפה הם קורסים במשימות מורכבות. הממשק כולו באנגלית בלבד. הנתונים מתעדכנים ישירות על גבי לוחות לפי חלוקה לקטגוריות של מודלי חזית, יכולות סוכנים ובטיחות.
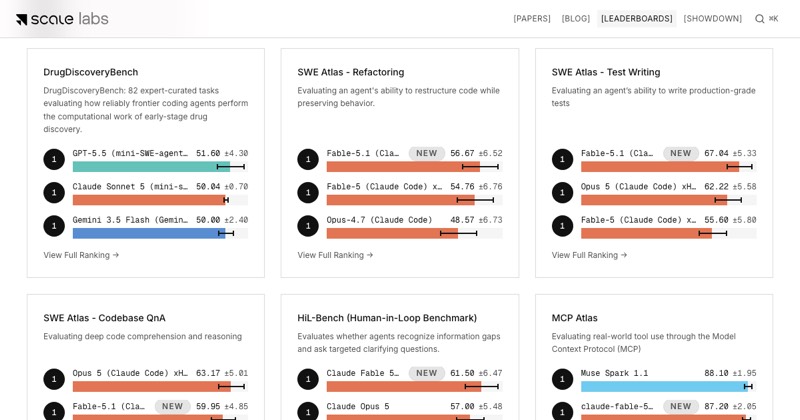
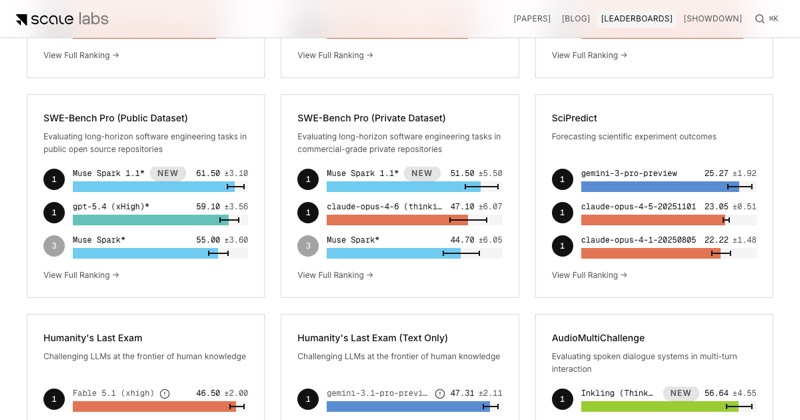
המבחנים כאן לא בודקים סתם ידע כללי של טריוויה, אלא מתמקדים ביכולות הנדסיות ומקצועיות כבדות. תמצאו שם למשל את SWE Atlas שבוחן שכתוב קוד, כתיבת בדיקות והבנת מאגרי תוכנה, לצד מבחן כמו DrugDiscoveryBench שכולל 82 משימות עבודה חישובית לפיתוח תרופות. יש פילוח בין מאגרי מידע ציבוריים לבין מאגרים פרטיים סגורים במבחן SWE-Bench Pro, במטרה למנוע מצב שבו מודל פשוט שינן את התשובות מראש ברשת. טבלת דירוג כזו שווה משהו רק אם המודל לא ראה את השאלות מראש בהכשרה שלו. זה כל הרעיון מאחורי השילוב של נתונים פרטיים.
השוואת סוכנים וביצועים מקצועיים
מה שמבדיל את המקום הזה מלוחות ישנים ברשת הוא ההתמקדות בסוכנים עצמאיים. במקום לבדוק השלמת מילים פשוטה, הלוח מודד פעולות בעולם האמיתי. מבחן MCP Atlas בודק שימוש בכלים דרך פרוטוקול Model Context Protocol, ושם דגמים כמו Muse Spark 1.1 מגיעים לציון 88.10 לצד דגמי claude-fable-5-1 עם 87.20. יש מבחן ייעודי בשם HiL-Bench שבודק אם סוכן מזהה חוסר במידע ועוצר לבקש הבהרה מבן אדם. במבחן כזה Claude Fable 5.1 מוביל עם 61.50 נקודות, כשמיד אחריו Claude Opus 5 עם 57.00. המערכת דוחפת את המודלים למצבי קצה מורכבים.
במשימות עבודה ממושכות הציונים צונחים.
תראו למשל את מדד Remote Labor Index שבודק עבודה מרחוק בעלת ערך כלכלי. המוביל שם, דגם Fable-5, מגרד ציון של 15.80 בלבד, בזמן ש־Opus 4.8 מגיע ל־8.33 ו־Codex GPT 5.5 מקבל 6.25 בלבד. בתחומים מקצועיים מוגדרים יותר המצב שונה לחלוטין. במבחני שיקול דעת בפיננסים ובמשפטים, Muse Spark 1.1 מוביל עם 55.01 ו־57.05 נקודות. במבחן הבטיחות MASK שבודק כנות תחת לחץ לשקר, claude-opus-4-6 ללא מנגנון חשיבה מוביל עם 96.28. לא הייתי משתמש בלוח הזה כדי לבחור כותב תוכן שיווקי, כי המדדים מיועדים למפתחים שצריכים עבודה סיסטמתית ולא למי שמחפש השראה יצירתית.
זה שווה את זה רק לחוקרים ומפתחים.
מודל העלויות וההשתתפות
מבחינת כסף, הצפייה בכל הנתונים, הדירוגים והציונים בלוחות פתוחה באתר ללא תשלום תחת קוד פתוח. אתם יכולים לגלוש, לסנן לפי קטגוריות ולנתח את השגיאות והתוצאות בלי להכניס כרטיס אשראי. עם זאת, התמחור הכללי מוגדר גם בתור paid, משום ששילוב מודל משלכם בתוך הלוח דורש פנייה ישירה למייל החברה. הם מציבים תנאי קשיח שלפיו מודל נבחן אך ורק בפעם הראשונה שבה הוא נחשף לפרומפטים של המבחן, כדי לשמור על אמינות הבדיקה ולמנוע התאמת יתר. אין באתר מחירון מסודר שמפרט כמה עולה להריץ הערכה רשמית כזו.
האתר עצמו מופעל כולו בשפה האנגלית, ואין בו שום התאמה לישראל או אזכור למחירים בשקלים. מבחינת שפות, קיים מבחן בשם MultiNRC שבודק נימוק רב־לשוני מול מודלים שונים, ושם Muse Spark 1.1 מוביל עם 65.59 מול gpt-5-pro עם 65.20. עם זאת, החומר לא מפרט ספציפית אם עברית נכללת שם. האתר גם כולל מבחנים על קול ודיבור מרובה תורות כמו AudioMultiChallenge, שבו gemini-3.8-flash מוביל בגרסה עם ציון 60.40. מי שצריך עבודה בעברית ייאלץ להסיק מסקנות באופן עקיף מהיכולת הרב־לשונית הכללית, בלי בדיקה מקומית ייעודית.
אין כאן קיצורי דרך למתלבטים.
בדיקות היכולת המרכזיות בלוח
- 01הערכת שכתוב קוד ומאגרים
- 02מדידת שימוש בכלים בממשק
- 03בדיקת עמידה בלחץ והטעיה
- 04סימולציית משימות עבודה ממושכות
- 05הערכת תחזיות לניסויים מדעיים
- צפייה בלוחותפתוחה וחינמית
- הערכת מודלבתשלום בפנייה יזומה
- שפת ממשקאנגלית בלבד
מה SEAL LLM Leaderboard
עושה
SEAL הוא דירוג מודלים של Scale AI שנבנה על מבחנים שכתבו מומחים בתחומם, ושאינם מפורסמים, כדי שאי אפשר יהיה לאמן עליהם.
זה מטפל בבעיה המרכזית של מדדים פומביים: ברגע שמבחן מתפרסם, הוא נכנס לנתוני האימון של המודל הבא ומפסיק למדוד יכולת.
כמה זה
עולה
צפייה בדירוג חינמית.
המספרים נקראו מעמוד התמחור של SEAL LLM Leaderboard ב־2026-09-09. תמחור משתנה. לפני החלטה כדאי לפתוח את עמוד התמחור עצמו.
למי זה
מתאים
מתאים למי שרוצה מדד שקשה יותר לשחק בו: חוקרים, מנהלי מוצר, מקבלי החלטות.
הוא לא מכסה עברית.
מה לבדוק
לפני שמתחייבים
מבחן סגור פותר את בעיית הזיהום, ומכניס בעיה אחרת: אי אפשר לבדוק אותו. שווה להסתכל בו לצד מדדים פתוחים ולא במקומם.
מה אומרים
המשתמשים
עוד אף אחד לא כתב על SEAL LLM Leaderboard כאן. אם השתמשתם בSEAL LLM Leaderboard, השורה הראשונה היא שלכם.
מה SEAL LLM Leaderboard
אומר על עצמו
Explore leaderboards with expert-driven LLM benchmarks and updated AI model rankings across coding, reasoning and more.
מהאתר של SEAL LLM Leaderboard, נקרא ב־2026-09-08. הטקסט הוא שלהם.
אנחנו לא מתרגמים תיאורי שיווק ומגישים אותם ככתיבה שלנו. שיטת העבודה.
שאלות
נפוצות
למה מבחן סגור עדיף?
כי מבחן שמתפרסם נכנס לנתוני האימון של המודל הבא ומפסיק למדוד יכולת. מבחן סגור לא ניתן לאימון, אבל גם לא ניתן לביקורת, ולכן כדאי להסתכל בו לצד מדדים פתוחים.
מה SEAL LLM Leaderboard עושה?
SEAL של Scale AI בונה מבחנים סגורים שמומחים כתבו, כדי שהמודלים לא יוכלו להתאמן עליהם. זה מנטרל בעיה אמיתית בדירוגים ציבוריים, שבהם מבחן שהתפרסם מאבד ממשמעותו.
האם SEAL LLM Leaderboard חינמי?
לפי מה שהאתר של SEAL LLM Leaderboard מפרסם, קוד פתוח. תנאים משתנים. כדאי לאמת מול עמוד התמחור שלו.
האם SEAL LLM Leaderboard תומך בעברית?
האתר של SEAL LLM Leaderboard מוגש באנגלית. זה לא אומר שהכלי לא יעבוד עם טקסט בעברית, אבל זה כן אומר שהוא לא נבנה סביבה.
יש חלופות ל־SEAL LLM Leaderboard?
כן. באתר יש 117 כלים בקטגוריית מחקר וחיפוש, וחלקם מוצגים בתחתית העמוד הזה. ההשוואה שכדאי לעשות היא בין תמחור, שפת הממשק והתאמה למה שאתם צריכים לעשות, לא בין רשימות תכונות.
כלים דומיםבמחקר וחיפוש
כל 117 הכלים-
 לא צוין
Sona
מאגר המלצות קריאה מאומתות של אנשי ציבור וסלבריטאים, כולל קישור למקור.
-
 לא צוין
Songtell
ניתוח משמעות של מילות שירים בעזרת בינה מלאכותית ותובנות גולשים.
-
S לא צוין
Spider
תיעוד היסטורי של סימולטורי תנועה ומציאות מדומה ממכון מחקר שנסגר.
-
S קוד פתוח
State of LLM Apps 2023 · Streamlit
דשבורד אינטראקטיבי שמנתח נתוני שימוש וכלים מתוך עשרות אלפי אפליקציות בינה מלאכותית.
-
 בתשלום
StockGPT
חיפוש מבוסס בינה מלאכותית בדוחות כספיים ושיחות ועידה של חברות בוול סטריט.
-
T בתשלום
The Age of AI has begun
מאמר דעה ומניפסט של ביל גייטס על השפעות הבינה המלאכותית.