מחקר וחיפוש · קוד פתוח

Open challenges in LLM research
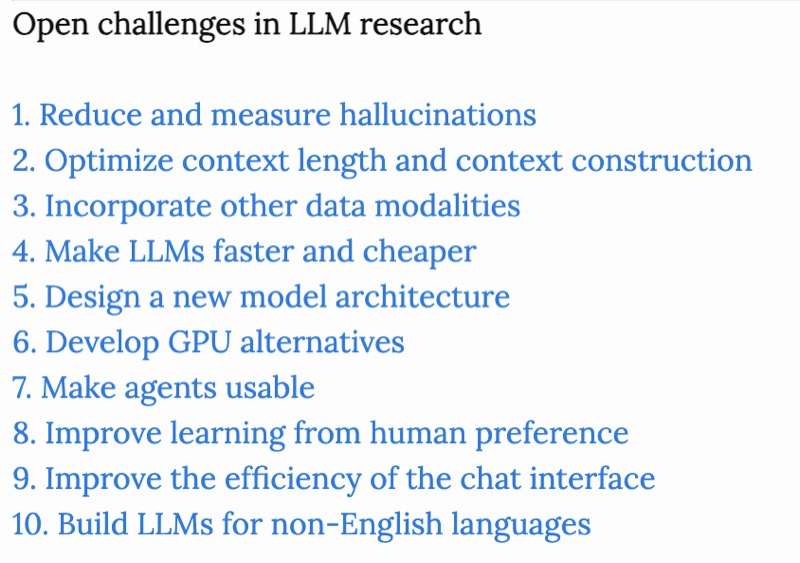
המאמר ממפה עשרה אתגרים מרכזיים בפיתוח מודלי שפה, החל מהזיות ועד אופטימיזציה של חומרה וארכיטקטורות חדשות. הוא מרכז ספרות אקדמית, פרויקטים בקוד פתוח ודיונים מתעשיית הבינה המלאכותית במקום אחד מסודר.
במקום לזרוק סיסמאות על בינה מלאכותית, הטקסט מפרק את הבעיות האמיתיות שמפתחים נתקלים בהן בשטח, כמו מגבלות זיכרון באימון, בניית הקשר יעיל בחיפושי מידע והקושי להעריך ביצועים בצורה אמינה.
- מחקר וחיפוש
- קוד פתוח
- ממשק באנגלית
דירוג הקהילה
תהיו הראשונים לדרג.
איך הדירוג עובד+
הדירוג פתוח רק למי שמחובר עם חשבון גוגל, דירוג אחד לכל אדם לכל כלי. זו הדרך שלנו לוודא שמדובר באדם אמיתי: היא אינה מוכיחה שהמדרג השתמש בכלי, וזה הבדל שכדאי לזכור כשקוראים ממוצע.
מי שכותב ביקורת מוצג בשמו הפרטי בלבד, כפי שהוא מופיע בחשבון גוגל. מעבר לזה לא נשמר דבר: לא שם משפחה, לא כתובת דוא״ל ולא תמונה: רק גיבוב חד־כיווני של מזהה החשבון, שמאפשר לכם לשנות את הדירוג שלכם ולא מאפשר לנו לדעת מי אתם.
ביקורת אינה יכולה להכיל קישורים, כתובות דוא״ל, מספרי טלפון או שמות משתמש. זה לא סינון תוכן, זה מה שמונע ממקום כזה להפוך ללוח מודעות.
- תמחור
- קוד פתוח
- קטגוריה
- מחקר וחיפוש
- שפת האתר
- אנגלית
- כתובת
- huyenchip.
com - נבדק
- 2026-09-08
הסקירה
כשנכנסים למאמר של צ'יפ הויין באתר שלה, מגלים סקירה טכנית מקיפה שממפה עשרה כיווני מחקר מרכזיים במודלי שפה גדולים, ולא ממשק עבודה או כפתור התחברות. היא מנתחת את האתגרים ההנדסיים שמונעים ממודלים להשתלב בצורה חלקה במוצרים אמיתיים, החל מהזיות ועד מגבלות זיכרון בחומרה. הטקסט נשען על שיחות שלה עם אנשי מקצוע וצוותים בחברות כמו Dropbox וגם Anthropic, ומציג פתרונות מחקריים לצד ניירות עמדה מהאקדמיה. מי שמחפש פה תוכנה להתקנה מיידית יתאכזב מהר מאוד, כי מדובר במפת דרכים תיאורטית ומעשית למפתחים ולא במוצר צריכה.
החומר הזה כתוב כולו באנגלית טכנית צפופה, עמוס בהפניות למאמרי מחקר ומתאים לחוקרים או למהנדסי בינה מלאכותית שמתכננים ארכיטקטורת מערכת מאפס.
הזיות, הקשר ומידע רב ערוצי
הבעיה הראשונה שמוצגת היא הנטייה של מודלים להמציא עובדות, קושי שמסומן על ידי חברות בתעשייה כחסם העיקרי למעבר לסביבת ייצור. המאמר סוקר שיטות מדידה וצמצום של התופעה, ומזכיר כלים כמו NeMo Guardrails של חברת NVIDIA לצד טכניקות מבוססות הקשר כמו שרשרת מחשבה. הנושא השני עוסק באופטימיזציה של אורך ההקשר ובשימוש הנרחב בשיטת RAG, שבה גוזרים מסמכים למקטעים, מייצרים מהם וקטורים ושומרים אותם בבסיס נתונים ייעודי. מחקרים שמצוטטים שם מוכיחים שמודלים מתקשים לקלוט מידע שקבור באמצע חלון ההקשר, ולכן סתם לדחוף עוד טקסט לא יפתור לכם את הבעיה.
חברות בתעשייה רואות בהזיות את החסם הראשון במעלה לאימוץ מודלים בסביבת ייצור.
התחום השלישי מדבר על שילוב מולטימודלי של טקסט, תמונות, וידאו ונתוני טבלאות. הצורך בזה מורגש היטב ברפואה, שם רופא נעזר במקביל בסיכומי ביקור ובסריקות דימות, או במסחר אלקטרוני שבו מקשרים תיאור של מוצר לתמונות שלו. הויין טוענת שדאטה טקסטואלי ברשת הולך ואוזל, ומודלים שיודעים לעבד כמה חושים במקביל יציגו ביצועים טובים יותר, מעבר לסיוע קונקרטי לאנשים עם לקויות ראייה לגלוש ברשת. היא מזכירה מודלים בולטים בתחום כמו Flamingo של חברת DeepMind ומודל CLIP של OpenAI, שממחישים את הכיוון הזה.
עקרונות עבודה בשיטת RAG
- 01איסוף מסמכי מקור לשימוש
- 02חלוקת מסמכים למקטעים מוגדרים
- 03יצירת וקטורים ושמירה במאגר
- 04המרת שאילתת משתמש לווקטור
- 05שליפת מקטעים דומים מהמאגר
דחיסת מודלים מתקדמת במהירות שיא. בנובמבר 2022 נדרשו 375GB של זיכרון כדי לאמן גרסה של GPT 3.5 בעלת 175 מיליארד פרמטרים. במאי 2023 מודל Guanaco 7B כבר רץ על 6GB בלבד עם כימות של 4 ביט, ואפשר להריץ אותו על מחשב נייד פשוט. הטכניקות שמניעות את השינוי הזה הן קוונטיזציה, זיקוק ידע, פירוק מטריצות בדרגה נמוכה וגיזום משקולות. מה שבאמת מפריע כאן הוא שאין כאן שום קוד מוכן להרצה, אלא רק מראי מקום למחקרים.
עלויות, קהל יעד ומגבלות
מבחינת כסף, מדובר במאמר בלוג פתוח לקריאה חופשית שאינו דורש תשלום כלל. עם זאת, היישום המעשי של מה שכתוב בו כרוך בעלויות כבדות. אתם תצטרכו לשלם על שרתי עיבוד, אחסון וקטורי וקריאות API לשירותים חיצוניים. הנתונים הרשמיים מתארים את הכלי כמוצר קוד פתוח לצד מודל בתשלום, בלי מחירון נקוב או מדרגות מחיר מוגדרות. לא הייתי משתמש בזה למשימות פרודוקטיביות יומיומיות כמו סיכום פגישות או ניהול יומן אישי. החומר מיועד אך ורק לצוותים טכניים שבונים תשתיות בעצמם ורוצים לחסוך שגיאות ארכיטקטורה יקרות.
עברית בכלל לא מוזכרת בסקירה הזו. המודלים והמחקרים שנבדקו אומנו בעיקר על אנגלית, ולכן התמודדות מקומית עם שפה מימין לשמאל דורשת התאמות עצמאיות שלכם.
- מחיר קריאהחינם ברשת
- תמיכה בעבריתלא מופיעה בחומר
- אופי הכליסקירת מחקר עיונית
מה Open challenges in LLM research
עושה
התוכן מנתח דרכים להפחתת הזיות בעזרת בדיקות עקביות עצמית והנחיות קצרות, ומציג את מנגנון שאיבת המידע בשני שלבים של חלוקת מסמכים לקטעים ושליפתם דרך וקטורים. הוא מציג מחקרים שמוכיחים שמודלים מתקשים לקלוט מידע שנמצא באמצע טקסט ארוך.
בנוסף, הטקסט מפרט ארבע שיטות לייעול מודלים: קוונטיזציה של פרמטרים לדיוק של 4 ביט, זיקוק ידע ממודל גדול לקטן, פירוק מטריצות לממדים נמוכים וגיזום. הוא מביא דוגמאות למודלים כמו אלפקה וגואנקו שהצליחו להוריד את דרישות הזיכרון ממאות גיגה בייט לכמה גיגה בודדים.
כמה זה
עולה
הטקסט עצמו פתוח לקריאה חופשית בבלוג, אך החומרים והכלים שהוא מזכיר כוללים שילוב של קוד פתוח לצד שירותים בתשלום. עלויות הפיתוח שתוארו נעות בין הרצת מודל קטן על מחשב נייד בחינם לבין אימון מודלים של מאות מיליארדי פרמטרים שדורש מערכי שרתים יקרים. האתר עצמו אינו מציג מחירון ישיר למוצר כלשהו.
המספרים נקראו מעמוד התמחור של Open challenges in LLM research ב־2026-09-09. תמחור משתנה. לפני החלטה כדאי לפתוח את עמוד התמחור עצמו.
למי זה
מתאים
מהנדסי תוכנה, חוקרים ואנשי דאטה שרוצים לבנות יישומים מבוססי שפה ומחפשים גישות פרקטיות להתמודדות עם בעיות של זמני תגובה, עלויות חומרה והזיות של מודלים.
מנהלים שלא עוסקים בצד הטכני או משתמשי קצה שמחפשים תוכנה מוכנה לשימוש יומיומי בעסק ולא מעוניינים בקריאת מאמרים אקדמיים על ארכיטקטורת רשתות וחישובי וקטורים.
מה לבדוק
לפני שמתחייבים
לפני שרצים ליישם פתרונות מהמאמר, כדאי לזכור שהוא נכתב באנגלית ולא עוסק במגבלות הספציפיות של עיבוד עברית, שבה חלוקת מילים לקטעים וחיפושי דמיון וקטורי דורשים התאמות מיוחדות. בעברית מודלים קטנים נוטים להציג ביצועים נמוכים בהרבה מהמספרים שמוצגים במחקרים באנגלית.
בנוסף, הטקסט מציג פתרונות אקדמיים שנמצאים עדיין בשלבי מחקר, כך ששיטות מסוימות לא מגיעות עם ספריות מוכנות ליציבות בייצור, והטמעתן עלולה לדרוש פיתוח עצמאי מורכב.
מה אומרים
המשתמשים
עוד אף אחד לא כתב על Open challenges in LLM research כאן. אם השתמשתם בOpen challenges in LLM research, השורה הראשונה היא שלכם.
מה Open challenges in LLM research
אומר על עצמו
[LinkedIn discussion, Twitter thread]
מהאתר של Open challenges in LLM research, נקרא ב־2026-09-08. הטקסט הוא שלהם.
אנחנו לא מתרגמים תיאורי שיווק ומגישים אותם ככתיבה שלנו. שיטת העבודה.
שאלות
נפוצות
איך אפשר להריץ מודלים חכמים בלי להוציא הון על שרתים?
המאמר מדגים שבאמצעות דחיסה לדיוק של 4 ביט ושימוש במודלים קטנים שעברו זיקוק, אפשר להריץ מודל של שבעה מיליארד פרמטרים עם שישה גיגה בייט זיכרון בלבד. זה מאפשר לפתח ולבדוק מערכות ישירות על מחשב אישי רגיל.
האם הקשר ארוך יותר במודל מבטיח תוצאה מדויקת יותר?
לא בהכרח, כי מחקרים מראים שמודלים מבינים מצוין את המידע בתחילת הקלט ובסופו, אך נוטים לאבד פרטים שמופיעים באמצע. לכן סידור נכון של הטקסט חשוב לא פחות מכמות המידע שמכניסים אליו.
מה Open challenges in LLM research עושה?
המאמר ממפה עשרה אתגרים מרכזיים בפיתוח מודלי שפה, החל מהזיות ועד אופטימיזציה של חומרה וארכיטקטורות חדשות. הוא מרכז ספרות אקדמית, פרויקטים בקוד פתוח ודיונים מתעשיית הבינה המלאכותית במקום אחד מסודר. במקום לזרוק סיסמאות על בינה מלאכותית, הטקסט מפרק את הבעיות האמיתיות שמפתחים נתקלים בהן בשטח, כמו מגבלות זיכרון באימון, בניית הקשר יעיל בחיפושי מידע והקושי להעריך ביצועים בצורה אמינה.
האם Open challenges in LLM research חינמי?
לפי מה שהאתר של Open challenges in LLM research מפרסם, קוד פתוח. תנאים משתנים. כדאי לאמת מול עמוד התמחור שלו.
האם Open challenges in LLM research תומך בעברית?
האתר של Open challenges in LLM research מוגש באנגלית. זה לא אומר שהכלי לא יעבוד עם טקסט בעברית, אבל זה כן אומר שהוא לא נבנה סביבה.
יש חלופות ל־Open challenges in LLM research?
כן. באתר יש 117 כלים בקטגוריית מחקר וחיפוש, וחלקם מוצגים בתחתית העמוד הזה. ההשוואה שכדאי לעשות היא בין תמחור, שפת הממשק והתאמה למה שאתם צריכים לעשות, לא בין רשימות תכונות.
כלים דומיםבמחקר וחיפוש
כל 117 הכלים-
 קוד פתוח
ossinsight.io chat-gpt-apps
ניתוח נתונים על מאגרי קוד פתוח עם חיפוש, טרנדים ומידע על אירועים.
-
 לא צוין
Paper Brain
קריאת מאמרים ומדריכים בנושאי נזקי גוף, תאונות ותביעות מוות ברשלנות.
-
 לא צוין
Paper Digest - ChatGPT
מרכז מחקרים אקדמיים עדכניים שנכתבו על ChatGPT ומקשר אותם לפטנטים ומענקים.
-
 בתשלום
Paralegal AI
מענה לשאלות משפטיות וסיכום של פסקי דין ומקורות רשת באנגלית.
-
 לא צוין
Partially Derivative
ארכיון פרקים של פודקאסט שעוסק במדע נתונים, בינה מלאכותית ולמידת מכונה.
-
 לא צוין
Perplexity
חיפוש מידע ברשת וקבלת תשובות ישירות ממקורות אמינים לצד עבודה על פרויקטים.