תמונות ועיצוב · לא צוין

NovelAI Improvements on Stable Diffusion | by NovelAI | Oct, 2022 | Medium
הצוות של NovelAI לקח את הארכיטקטורה של סטייבל דיפיוז'ן ושינה את תהליך האימון שלה כדי להתאים אותה ליצירת תמונות עבור סיפורים, עם דגש על מודל בסגנון אנימה. השינוי התמקד בשני עקרונות טכניים: שימוש בשכבה הלפני אחרונה של מקודד הטקסט, ואימון על תמונות בגדלים משתנים במקום חיתוך לריבועים בלבד.
מה שמבדיל את הפיתוח הזה ממודלים בסיסיים הוא שיטת החלוקה לדליים של יחסי גובה רוחב. במקום לקצוץ תמונות לריבועים של 512 על 512 ולחתוך ראשים או רגליים, המערכת מאמנת על גדלים שונים וכך שומרת על שלמות הדמויות והקשר שבין המילים לתמונה.
- תמונות ועיצוב
- לא צוין
- ממשק באנגלית
דירוג הקהילה
תהיו הראשונים לדרג.
איך הדירוג עובד+
הדירוג פתוח רק למי שמחובר עם חשבון גוגל, דירוג אחד לכל אדם לכל כלי. זו הדרך שלנו לוודא שמדובר באדם אמיתי: היא אינה מוכיחה שהמדרג השתמש בכלי, וזה הבדל שכדאי לזכור כשקוראים ממוצע.
מי שכותב ביקורת מוצג בשמו הפרטי בלבד, כפי שהוא מופיע בחשבון גוגל. מעבר לזה לא נשמר דבר: לא שם משפחה, לא כתובת דוא״ל ולא תמונה: רק גיבוב חד־כיווני של מזהה החשבון, שמאפשר לכם לשנות את הדירוג שלכם ולא מאפשר לנו לדעת מי אתם.
ביקורת אינה יכולה להכיל קישורים, כתובות דוא״ל, מספרי טלפון או שמות משתמש. זה לא סינון תוכן, זה מה שמונע ממקום כזה להפוך ללוח מודעות.
- תמחור
- לא צוין
- קטגוריה
- תמונות ועיצוב
- שפת האתר
- אנגלית
- כתובת
- blog.
novelai. net - נבדק
- 2026-09-09
הסקירה
צוות הפיתוח של NovelAI שינה מן היסוד את האופן שבו מודל Stable Diffusion מעבד תמונות וטקסט בזמן האימון. במקום לחתוך כל תמונה לריבוע מושלם של 512 על 512 פיקסלים, המפתחים יצרו שיטה שממיינת תמונות לפי יחסי גובה ורוחב שונים. המטרה המרכזית הייתה לפתור את בעיית הדמויות החתוכות, שבהן אנשים מופיעים בלי ראש או בלי רגליים וחרבות נקטעות באמצע הלהב.
השינוי הזה נולד מתוך צורך מעשי מאוד של החברה. הם רצו לייצר תמונות שילוו סיפורים כתובים, ושם אי אפשר להסתפק בקומפוזיציות קטועות.
הבעיה הבסיסית במודלים של יצירת תמונות היא הצורך לאמן כרטיסי מסך על קבוצות של תמונות בגודל זהה. כשמאמנים מודל רגיל, פשוט חותכים את מרכז התמונה. הפעולה הזו יצרה מצב אבסורדי שבו תגיות טקסט לא תאמו את מה שנשאר בתמונה. אם בתגית המקורית הופיעה המילה כתר, אבל החיתוך השאיר רק את הגוף וערף את ראש המלך, המודל למד לקשר בין המילה כתר לבין גוף חסר ראש. ב־NovelAI הבינו שגם חיתוך אקראי לא פותר את הבעיה, ולכן בנו תהליך של חלוקה לדליים שמקבץ תמונות דומות ביחס הממדים שלהן עד גודל מירבי של 512 על 768 פיקסלים.
שליפה מהשכבה הלפני אחרונה
החלק השני בשינוי נוגע למנוע הטקסט CLIP שאחראי על הבנת ההנחיות שלכם. בדרך כלל, Stable Diffusion לוקח את המידע מהשכבה האחרונה של המקודד כדי להנחות את היצירה. החוקרים של NovelAI בחרו להשתמש דווקא בשכבה הלפני אחרונה, תוך הפעלת נרמול השכבה הסופי של הטרנספורמר. השכבה האחרונה מרכזת את המידע בצורה חדה מדי עבור חיפוש דמיון וקטורי, ולכן היא מאבדת פרטים קטנים. השימוש בשכבה הלפני אחרונה מאפשר למודל להפריד בצורה נקייה בין תכונות שונות באותו הפרומפט, כך שצבע אחד לא ידלוף לחלקים אחרים של הדמות.
שלבי המיון לדליי יחס תמונה
- 01הגדרת רוחב התחלתי מ־256 פיקסלים
- 02חישוב הגובה המירבי לפי שטח
- 03הגדלת הממדים בקפיצות של 64
- 04הסרת כפילויות והוספת ריבוע בסיסי
- 05שיוך כל תמונה לדלי הקרוב
- 06חלוקה למנות עבודה לפי מעבדים
השימוש בשכבה הלפני אחרונה מאפשר למודל להפריד מושגים מורכבים ולמנוע זליגת צבעים בין פריטי לבוש שונים.
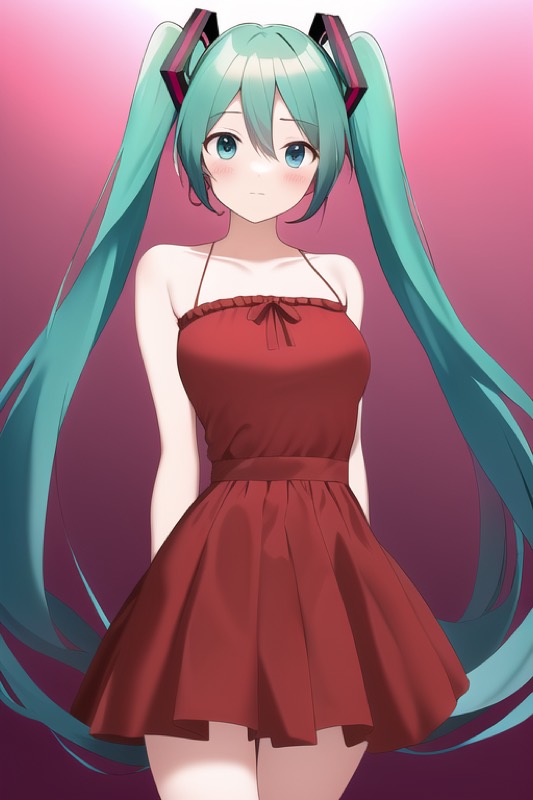
באימונים המוקדמים עם השכבה הרגילה, פרומפטים פשוטים יחסית גרמו לבעיות קשות. למשל, בבקשה לדמות Hatsune Miku עם שמלה אדומה, הצבע האדום של השמלה נטה לזלוג ישירות לתוך העיניים והשיער שלה. רק לאחר המעבר לשכבה הלפני אחרונה המודל הצליח להפריד בין הדברים. הוא התמודד בהצלחה עם הנחיות ארוכות ומפורטות שהכילו עשר תגיות שונות במקביל, כולל צבעי עיניים סגולים, חולצה אדומה, חצאית קפלים וצעיף ירוק, בלי שאף צבע יכתים את הפריט הלא נכון.
המערכת הזו דורשת המון כוח חישוב. מעבר לגודל 512 על 768 מחייב צריכת זיכרון גבוהה בהרבה בכרטיסי המסך, ולכן הצוות נאלץ להקטין את גודל הקבוצות המעובדות בכל מעבד גרפי ולפצות על כך בעזרת צבירת גרדיאנטים. הם פיצלו את הנתונים בין מעבדים שונים, ערבבו את מזהי התמונות בכל סבב אימון, והעבירו שאריות שלא התחלקו בדיוק לתוך דלי איסוף מיוחד כדי ששום מעבד לא ייתקע בחוסר עבודה.
למי השיטה הזו מתאימה
זה שווה את זה רק אם אתם מאמנים מודלים משלכם או מחפשים יצירת תמונות אנימה ואיורים שבהם כל פרט בבגדים חייב לשבת בדיוק במקום. מי שרוצה לייצר תמונות כלליות של נופים או חפצים לא ירגיש כאן שום הבדל דרמטי. אם אתם מצפים לתמיכה מובנית בעברית, תשכחו מזה כרגע. המודל מתבסס כולו על תיוג באנגלית ובנוי סביב מילות מפתח מופרדות בפסיקים. הוא אינו מיועד לפרומפטים שכתובים בשפה טבעית ובוודאי שלא בעברית, כך שתצטרכו לתרגם כל מושג לאנגלית כדי להפיק ממנו משהו הגיוני.
- מחיר שירותלא צוין בפוסט
- שפת ממשקאנגלית בלבד
- שיפור דיוקהפרדת צבעים מלאה
מה שבאמת מפריע כאן הוא שאין בטקסט שום נתון על המחיר שמשתמש הקצה ישלם. מדובר בפוסט הנדסי נקי, כזה שמציג פתרונות תשתית בלי שום התייחסות למנויים או עלויות שרתים. לא הייתי משתמש בזה לפרויקטים שדורשים שליטה מלאה בתקציב חודשי בלי לבדוק קודם את האותיות הקטנות באתר שלהם.
מה NovelAI Improvements on Stable Diffusion | by NovelAI | Oct, 2022 | Medium
עושה
במהלך האימון המודל מקבל מידע משכבת הטקסט הלפני אחרונה של CLIP במקום מהשכבה הסופית, בצירוף שכבת נירמול. לפי המפתחים, זה מונע זליגת צבעים בין פריטים שונים בתיאור ומאפשר לחבר נכון בין תגיות מרובות כמו צבע שיער, לבוש והבעות פנים.
במקביל, המערכת ממיינת את תמונות האימון לפי יחסי הגובה והרוחב שלהן לתוך דליים מוגדרים מראש, שנעים בין רוחב של 256 עד 1024 פיקסלים בשטח מקסימלי של 512 על 768. בכל שלב נשלפת קבוצת תמונות שכולן באותו גודל בדיוק, מה שמאפשר למעבדים הגרפיים לעבוד ביעילות בלי לכפות חיתוך ריבועי על התוצאה הסופית.
כמה זה
עולה
האתר לא מפרסם מחיר במאמר הטכני הזה.
למי זה
מתאים
זה מיועד ליוצרים שמחפשים לייצר דמויות בסגנון אנימה מתוך תיאורים מפורטים המבוססים על תגיות, ושחשוב להם לקבל קומפוזיציות שלמות בלי חלקי גוף שנקטעים בגלל מגבלות חיתוך.
זה לא מתאים למי שרוצה מודל רב תכליתי לתמונות ריאליסטיות כלליות, עיצוב גרפי מסחרי או צילום, וגם לא למי שמחפש פתרון פשוט בלי להבין איך תגיות משפיעות על התוצאה.
מה לבדוק
לפני שמתחייבים
המאמר מציג רק את הצד הטכני של האימון ולא מספק פרטים על ממשק המשתמש, שמירת היסטוריית היצירות או תנאי הרישיון המסחרי של התמונות שנוצרות. בנוסף, כל שיטת התיוג נשענת על אנגלית בלבד ומבוססת על מוסכמות של קהילות איור, כך שאין שום תמיכה בהזנת תיאורים בעברית.
מה אומרים
המשתמשים
עוד אף אחד לא כתב על NovelAI Improvements on Stable Diffusion | by NovelAI | Oct, 2022 | Medium כאן. אם השתמשתם בNovelAI Improvements on Stable Diffusion | by NovelAI | Oct, 2022 | Medium, השורה הראשונה היא שלכם.
מה NovelAI Improvements on Stable Diffusion | by NovelAI | Oct, 2022 | Medium
אומר על עצמו
NovelAI Improvements on Stable Diffusion As part of the development process for our NovelAI Diffusion image generation models, we modified the model architecture of Stable Diffusion and its training …
מהאתר של NovelAI Improvements on Stable Diffusion | by NovelAI | Oct, 2022 | Medium, נקרא ב־2026-09-09. הטקסט הוא שלהם.
אנחנו לא מתרגמים תיאורי שיווק ומגישים אותם ככתיבה שלנו. שיטת העבודה.
שאלות
נפוצות
למה המודל מתמקד דווקא בסגנון אנימה?
המאמר מדגים את השיפורים על מודל האנימה שלהם, שבו יש חשיבות גדולה להפרדה בין תגיות מרובות כמו צבעי שיער, בגדים ואביזרים שונים באותה דמות.
מה קורה לתמונות עם יחס גובה רוחב חריג במיוחד?
אם יחס הגובה רוחב של תמונה רחוק מדי מכל הדליים שהוגדרו מראש, המערכת פשוט מסירה אותה ממאגר הנתונים ולא משתמשת בה לאימון.
מה NovelAI Improvements on Stable Diffusion | by NovelAI | Oct, 2022 | Medium עושה?
הצוות של NovelAI לקח את הארכיטקטורה של סטייבל דיפיוז'ן ושינה את תהליך האימון שלה כדי להתאים אותה ליצירת תמונות עבור סיפורים, עם דגש על מודל בסגנון אנימה. השינוי התמקד בשני עקרונות טכניים: שימוש בשכבה הלפני אחרונה של מקודד הטקסט, ואימון על תמונות בגדלים משתנים במקום חיתוך לריבועים בלבד. מה שמבדיל את הפיתוח הזה ממודלים בסיסיים הוא שיטת החלוקה לדליים של יחסי גובה רוחב. במקום לקצוץ תמונות לריבועים של 512 על 512 ולחתוך ראשים או רגליים, המערכת מאמנת על גדלים שונים וכך שומרת על שלמות הדמויות והקשר שבין המילים לתמונה.
האם NovelAI Improvements on Stable Diffusion | by NovelAI | Oct, 2022 | Medium חינמי?
באתר של NovelAI Improvements on Stable Diffusion | by NovelAI | Oct, 2022 | Medium לא נמצא מידע ברור על תמחור בזמן הבדיקה (2026-09-09).
האם NovelAI Improvements on Stable Diffusion | by NovelAI | Oct, 2022 | Medium תומך בעברית?
האתר של NovelAI Improvements on Stable Diffusion | by NovelAI | Oct, 2022 | Medium מוגש באנגלית. זה לא אומר שהכלי לא יעבוד עם טקסט בעברית, אבל זה כן אומר שהוא לא נבנה סביבה.
יש חלופות ל־NovelAI Improvements on Stable Diffusion | by NovelAI | Oct, 2022 | Medium?
כן. באתר יש 183 כלים בקטגוריית תמונות ועיצוב, וחלקם מוצגים בתחתית העמוד הזה. ההשוואה שכדאי לעשות היא בין תמחור, שפת הממשק והתאמה למה שאתם צריכים לעשות, לא בין רשימות תכונות.
כלים דומיםבתמונות ועיצוב
כל 183 הכלים-
 בתשלום
OpenArt
מרכז יותר ממאה מודלים ליצירת תמונות, וידאו ומוזיקה, עם מסלול חינם.
-
 לא צוין
Ostagram.ru
מיזוג סגנונות אמנותיים ותמונות מקור ליצירת תמונות חדשות בפיד ציבורי.
-
 לא צוין
PaintsChainer
צביעה אוטומטית של איורים וסקיצות בעזרת מודלים ייעודיים לצבע והצללה.
-
 יש מסלול חינם
Palette
הפיכת תמונות שחור-לבן לצבעוניות בעזרת מסננים והזנת מילות מפתח
-
 לא צוין
PatternedAI
מחולל דוגמאות טקסטיל ומשטחים חוזרים ורציפים להדפסה לפי טקסט, תמונה או עריכה.
-
 לא צוין
Petpic
אימון מודל תמונות על חיית המחמד שלכם ויצירת גרסאות שלה בסגנונות שונים.