מחקר וחיפוש · לא צוין

CompMix
הפרויקט הזה הוא מאגר נתונים מחקרי שמיועד למדידה ולבחינה של מודלים לעיבוד שפה טבעית. הוא לא תוכנה שמתקינים ולא שירות שמתחברים אליו כדי לקבל תשובות ביום יום. החומר נאסף על ידי מכון מקס פלאנק למדעי המחשב, ומציע קובץ של שאלות מורכבות שנכתבו על ידי בני אדם כדי לאתגר מערכות בינה מלאכותית.
מה שמייחד אותו לעומת מאגרי שאלות ותשובות רגילים הוא השילוב של מקורות מידע שונים לחלוטין. התשובות לא נמצאות רק בטקסט חופשי, אלא מחייבות הצלבה בין עמודי ויקיפדיה, טבלאות, תיבות מידע מובנות ומאגר הנתונים המובנה ויקינתונים, כך שהמערכת הנבדקת חייבת לדעת לעבוד עם סוגי מידע מגוונים בו זמנית.
- מחקר וחיפוש
- לא צוין
- ממשק באנגלית
דירוג הקהילה
תהיו הראשונים לדרג.
איך הדירוג עובד+
הדירוג פתוח רק למי שמחובר עם חשבון גוגל, דירוג אחד לכל אדם לכל כלי. זו הדרך שלנו לוודא שמדובר באדם אמיתי: היא אינה מוכיחה שהמדרג השתמש בכלי, וזה הבדל שכדאי לזכור כשקוראים ממוצע.
מי שכותב ביקורת מוצג בשמו הפרטי בלבד, כפי שהוא מופיע בחשבון גוגל. מעבר לזה לא נשמר דבר: לא שם משפחה, לא כתובת דוא״ל ולא תמונה: רק גיבוב חד־כיווני של מזהה החשבון, שמאפשר לכם לשנות את הדירוג שלכם ולא מאפשר לנו לדעת מי אתם.
ביקורת אינה יכולה להכיל קישורים, כתובות דוא״ל, מספרי טלפון או שמות משתמש. זה לא סינון תוכן, זה מה שמונע ממקום כזה להפוך ללוח מודעות.
- תמחור
- לא צוין
- קטגוריה
- מחקר וחיפוש
- שפת האתר
- אנגלית
- כתובת
- qa.
mpi-inf. mpg. de - נבדק
- 2026-09-08
הסקירה
CompMix מוריד למחשב שלכם קובצי נתונים בפורמט JSON שמכילים אלפי שאלות ותשובות מוכנות מראש. הוא לא תוכנה שרצה ברקע, הוא לא אתר שבו מקלידים שאלה בתיבת חיפוש, ואין מאחוריו שרת שמחזיר תשובה לשאילתות שלכם בזמן אמת. אם הגעתם אליו במחשבה שמצאתם כלי עבודה שיעזור לכם לנהל פרויקטים, לסכם מיילים או לחסוך זמן במשרד, תגלו מהר מאוד שטעיתם בכתובת. זהו מאגר נתונים למחקר שנועד לבחון ביצועים של מודלים לשאלות ותשובות. מה שמקבלים זה קבצים עמוסים בטקסטים מובנים שדורשים ידע טכני בעיבוד נתונים כדי לעשות בהם שימוש מעשי כלשהו.
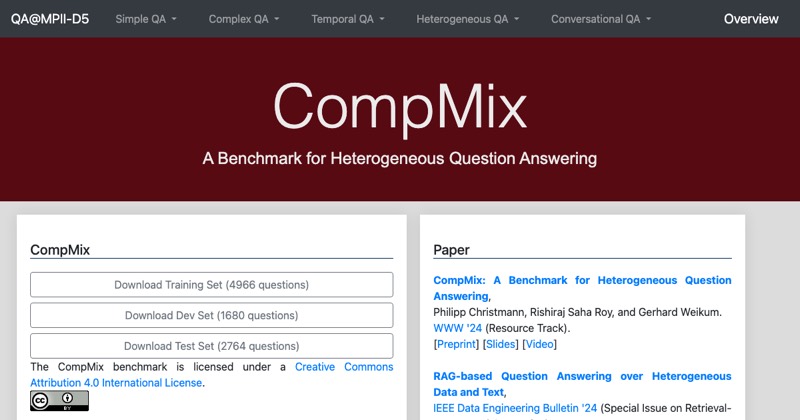
הקובץ כולל בסך הכל 9,410 שאלות שנאספו מבני אדם ועברו פיצול מדויק לשלושה חלקים נפרדים באתר. החלק הראשון הוא ערכת האימון עם 4,966 שאלות שמיועדות להזנה למודלים בתהליך הלמידה. החלק השני מכיל 1,680 שאלות לפיתוח ובדיקת ביניים, והחלק השלישי מציע 2,764 שאלות שמורות למבחן הסופי. בנוסף לקבצים באתר, המאגר כולו מועלה גם ישירות לחשבון של היוצרים באתר Hugging Face. מי שעובד עם המערכות האלה ביום יום יכול למשוך את הנתונים משם בלי להוריד אותם ידנית אחד אחד.
איך נבנה מאגר השאלות
מאחורי השאלות האלה עומדים עובדים מפלטפורמת Amazon Mechanical Turk שהתבקשו לבחור ישות מסוימת מתחום שעניין אותם, וממנה לפתח שיחה טבעית. המטרה המרכזית היתה להבטיח שהשאלות לא ייראו מלאכותיות או יובשו על ידי נוסחאות קבועות מראש. העובדים דילגו בין נושאים שונים במהלך השיחה בדיוק כמו שבני אדם עושים בחיים האמיתיים. הם בחרו ישויות מורכבות, שאלו עליהן ברצף, ויצרו תערובת אמיתית של שאלות מורכבות ומגוונות. CompMix הוא מאגר לבדיקת אלגוריתמים ולא תוכנת פרודוקטיביות לעבודה יומיומית.
החומר מבוסס על מאגר קודם בשם ConvMix, אבל כאן לקחו את השאלות המקוריות והשלימו אותן. בשיחה רגילה אדם שואל שאלה קצרה שמסתמכת על המשפט הקודם, כמו למשל מתי הוא נולד, בלי לציין שוב את השם. בתוך CompMix העובדים שכתבו כל משפט כזה לשאלה עצמאית ומפורשת שמכילה את כל הכוונות והשמות המלאים. כך המודל הנבדק מקבל שאלות שלמות שהוא אמור לדעת לפתור לגמרי לבד בלי לקרוא את כל ההיסטוריה של השיחה שקדמה להן.
זה דורש תכנות נטו.
שלבי יצירת הנתונים במאגר
- 01בחירת ישות עניין בעבודה
- 02ניסוח שאלות שיחה טבעיות
- 03מעבר עצמאי בין נושאים
- 04איתור תשובה במקורות הידע
- 05שכתוב שאלות למבנה עצמאי
מקורות המידע ומבנה השאלות
הייחוד שיוצרי המאגר מכוונים אליו הוא בדיקת שיטות שפועלות מול תערובת של מקורות מידע שונים לחלוטין באופיים. העובדים נדרשו למצוא תשובה לכל שאלה שהמציאו באחד מארבעה מקורות מוגדרים: מאגר הנתונים המובנה של Wikidata, טקסט חופשי מתוך ויקיפדיה, טבלאות מתוך ויקיפדיה, או תיבות מידע בערכים. כדי להתמודד עם המבנה המורכב של Wikidata, החוקרים אפילו סיפקו לעובדים סרטוני הדרכה שליוו שיחה לדוגמה. המאגר כולל לא רק את השאלה והתשובה, אלא גם את המקור הספציפי שבו נמצאה התשובה ואת הישויות שזוהו בתוך הטקסט.
השאלות שנוצרו כוללות תופעות לשוניות מורכבות מאוד שמקשות על מערכות חיפוש רגילות. תמצאו שם תנאי זמן, השוואות כמותיות, אוסף של כמה ישויות במשפט בודד ופעולות של צבירת נתונים. כל התשובות מקושרות ישירות לבסיס הידע, למעט תאריכים שעברו נרמול ושמות פרטיים שנשמרו כטקסט פשוט. מגוון הנושאים רחב באופן חריג ונע בין מועדוני כדורגל כמו Liverpool, דמויות מסרטים כמו Titanic, סופרים, ועד שחקנים וזמרים. יש כאן עושר עצום של פרטים.
אין כאן ממשק משתמש.
תנאי רישיון ועלויות שימוש
כל הנתונים במיזם הזה פתוחים לחלוטין לשימוש חופשי ומופצים תחת רישיון Creative Commons Attribution 4.0 International. אין באתר שום מחירון, אין מנויים חודשיים, ואתם לא צריכים לשלוף כרטיס אשראי כדי ללחוץ על הקישורים ולהוריד את המידע. מהבחינה הזו הוא זמין לכולם בלי תשלום ישיר ליוצרים. עם זאת, כדי לעשות בזה שימוש במחקר או בפיתוח, תצטרכו להחזיק תשתיות מחשוב משלכם כדי להריץ את המודלים על גבי הקבצים הללו, וזה כבר עולה כסף בפני עצמו.
לא הייתי משתמש בזה לפיתוח מוצר שמיועד לשוק המקומי בישראל. כל 9,410 השאלות והתשובות מנוסחות באנגלית ומבוססות על ויקיפדיה האנגלית ובסיסי ידע בינלאומיים. המאגר לא מכיל שום תוכן בעברית ולא תוכנן לבחון מודלים בשפה הזו. חוקר ישראלי שבונה מערכת שאלות ותשובות באנגלית ימצא כאן כר פורה לניסויים, אבל אם המטרה שלכם היא מנוע חיפוש או עוזר פנימי בעברית לארגון שלכם, הקבצים האלה לא יקדמו אתכם.
- מחירוןלא צוין באתר
- רישיוןשימוש חופשי בינלאומי
- שפת נתוניםאנגלית בלבד
מה CompMix
עושה
המאגר מכיל 9,410 שאלות מלאות ועצמאיות שמבוססות על שאלות שנלקחו מתוך שיחות טבעיות. עובדים בפלטפורמת אמזון טורק ניסחו מחדש כל שאלה כך שתהיה מפורשת וברורה בלי צורך בהקשר של השיחה המקורית. השאלות כוללות תנאים בזמן, השוואות בין פריטים, יחסים מורכבים וחישובים מצרפיים, והן עוסקות בישויות אמיתיות מתחומי בידור, ספורט, תרבות וספרות.
הקובץ מחולק מראש לשלושה חלקים מוכנים לעבודה. יש בו 4,966 שאלות לאימון, 1,680 שאלות לכוונון, ו־2,764 שאלות לבדיקה סופית של המודל. כל שאלה מגיעה עם התשובה המדויקת שמעוגנת במאגר ויקינתונים, פרט לתאריכים שעברו נרמול ושמות טקסטואליים, וכן עם ציון המקור הספציפי שבו העובד מצא את המידע בוויקיפדיה. הנתונים זמינים להורדה ישירה כקובצי ג'ייסון או דרך חיבור למאגר האגינג פייס.
כמה זה
עולה
האתר לא מפרסם מחיר לשימוש במאגר. כל הקבצים פתוחים להורדה חופשית וזמינים תחת רישיון קריאייטיב קומונס ייחוס 4.0 בינלאומי ללא תשלום, כך שאין כאן מדרגות מחיר, מסלולי רכישה או התלבטות כספית שרלוונטית לקוראים.
למי זה
מתאים
זה מתאים לחוקרים, למדעני נתונים ולמפתחי מערכות בינה מלאכותית שעובדים על אלגוריתמים של שליפת מידע ומענה לשאלות. אם אתם בונים מודל שצריך לדעת לחפש מידע גם בטבלאות וגם בגרפי ידע מובנים במקביל לטקסט רגיל, המאגר הזה נותן לכם סרגל מדידה מסודר לבדוק את הביצועים שלו.
זה לא מיועד למי שמחפש כלי עבודה משרדי, מנוע חיפוש פנימי לארגון או תוכנה מוכנה לניהול ידע. אין פה ממשק גרפי לשאילת שאלות, אין פה בוט שאפשר להתקין, ואם אתם לא עוסקים באימון והערכה של מודלים ברמת הקוד, אין לכם מה לעשות עם הקבצים האלה.
מה לבדוק
לפני שמתחייבים
לפני שמורידים את הנתונים, חשוב לקחת בחשבון שכל המאגר מבוסס על אנגלית ועל ערכי ויקיפדיה באנגלית. אם אתם בונים מודל שצריך לתת מענה בעברית, הנתונים כאן לא יעזרו לכם באופן ישיר בלי עבודת תרגום והתאמה משמעותית למקורות מקומיים.
בנוסף, הרישיון דורש מתן קרדיט ליוצרים, כך שאם אתם מתכננים להשתמש בזה במוצר מסחרי צריך לוודא שאתם עומדים בתנאי הרישיון. כדאי גם לשים לב שההסתמכות על ויקינתונים דורשת מהאלגוריתם שלכם יכולת חיבור לגרף ידע, ולא רק סריקה של טקסט רגיל.
מה אומרים
המשתמשים
עוד אף אחד לא כתב על CompMix כאן. אם השתמשתם בCompMix, השורה הראשונה היא שלכם.
מה CompMix
אומר על עצמו
CompMix: A Benchmark for Heterogeneous Question Answering.
מהאתר של CompMix, נקרא ב־2026-09-08. הטקסט הוא שלהם.
אנחנו לא מתרגמים תיאורי שיווק ומגישים אותם ככתיבה שלנו. שיטת העבודה.
שאלות
נפוצות
האם אפשר להשתמש במאגר באופן מסחרי?
הרישיון של המאגר הוא קריאייטיב קומונס 4.0 עם ייחוס. רישיון זה מאפשר עקרונית שימוש מסחרי, ובלבד שאתם מעניקים קרדיט מתאים למכון מקס פלאנק ומציינים אם נעשו שינויים בקובצי הנתונים.
איפה מוצאים את הקבצים של המאגר?
הקבצים זמינים להורדה ישירה כקובצי ג'ייסון ישירות משרתי מכון מקס פלאנק. לחלופין, אפשר לטעון אותם ישירות לקוד פייתון דרך ספריית מאגרי הנתונים של האגינג פייס.
מה CompMix עושה?
הפרויקט הזה הוא מאגר נתונים מחקרי שמיועד למדידה ולבחינה של מודלים לעיבוד שפה טבעית. הוא לא תוכנה שמתקינים ולא שירות שמתחברים אליו כדי לקבל תשובות ביום יום. החומר נאסף על ידי מכון מקס פלאנק למדעי המחשב, ומציע קובץ של שאלות מורכבות שנכתבו על ידי בני אדם כדי לאתגר מערכות בינה מלאכותית. מה שמייחד אותו לעומת מאגרי שאלות ותשובות רגילים הוא השילוב של מקורות מידע שונים לחלוטין. התשובות לא נמצאות רק בטקסט חופשי, אלא מחייבות הצלבה בין עמודי ויקיפדיה, טבלאות, תיבות מידע מובנות ומאגר הנתונים המובנה ויקינתונים, כך שהמערכת הנבדקת חייבת לדעת לעבוד עם סוגי מידע מגוונים בו זמנית.
האם CompMix חינמי?
באתר של CompMix לא נמצא מידע ברור על תמחור בזמן הבדיקה (2026-09-08).
האם CompMix תומך בעברית?
האתר של CompMix מוגש באנגלית. זה לא אומר שהכלי לא יעבוד עם טקסט בעברית, אבל זה כן אומר שהוא לא נבנה סביבה.
יש חלופות ל־CompMix?
כן. באתר יש 117 כלים בקטגוריית מחקר וחיפוש, וחלקם מוצגים בתחתית העמוד הזה. ההשוואה שכדאי לעשות היא בין תמחור, שפת הממשק והתאמה למה שאתם צריכים לעשות, לא בין רשימות תכונות.
כלים דומיםבמחקר וחיפוש
כל 117 הכלים-
 יש מסלול חינם
ContextWire
API חיפוש חינמי לסוכני AI, עם 105 מנועים ואלף שאילתות בחודש.
-
 לא צוין
CoolGiftIdeas
הצעת רעיונות למתנות בהתאמה אישית לפי תיאור האדם שעבורו קונים.
-
 בתשלום
Data Stories
האזנה לפודקאסט מקצועי על ויזואליזציית נתונים ועיון בתמלילים ובקוד פתוח של פרקיו.
-
 לא צוין
Deconstructing the AI Myth: Fallacies and Harms of Algorithmification
מאמר אקדמי שמנתח באופן ביקורתי את מיתוסי הבינה המלאכותית והשפעות האלגוריתמיזציה.
-
 בתשלום
Documind.chat
העלאת קובצי PDF בכמות גדולה, תשאול המידע ואימון צ'אטבוט להטמעה באתר
-
 לא צוין
DraftLab
איתור פרטי בעלים ומיקום של מספרי טלפון בארצות הברית לפי מספר בלבד.